On-device advertising : cas d’usage, contraintes et signaux disponibles
L’enjeu se déplace du ciblage exposé vers l’intelligence exécutée localement
L’on-device advertising désigne les mécanismes publicitaires dans lesquels une partie du ciblage, de la décision, de la mesure ou de l’optimisation s’exécute directement sur le terminal de l’utilisateur : smartphone, ordinateur, télévision connectée, box opérateur, console, navigateur ou application. Le principe n’est pas seulement technique. Il répond à une contrainte structurelle de l’AdTech : les signaux individuels circulent moins librement entre éditeurs, plateformes, annonceurs et intermédiaires, sous l’effet combiné du consentement, des restrictions navigateur, de l’ATT, App Tracking Transparency, cadre d’Apple encadrant l’accès à l’identifiant publicitaire sur iOS, et de la pression réglementaire sur les données personnelles.
Dans un modèle programmatique classique, le DSP, demand-side platform, plateforme d’achat utilisée par les annonceurs pour enchérir automatiquement sur des impressions, reçoit une bid request, demande d’enchère transmise par une SSP, supply-side platform, plateforme permettant aux éditeurs de vendre leur inventaire. Cette requête peut contenir des informations de contexte, d’appareil, de géographie, d’identifiant et parfois d’audience. Plus cette requête est riche, plus le DSP peut décider finement. Mais ce modèle devient plus fragile lorsque les identifiants tiers disparaissent, lorsque le consentement limite les finalités de traitement ou lorsque les plateformes ferment l’accès à certains signaux.
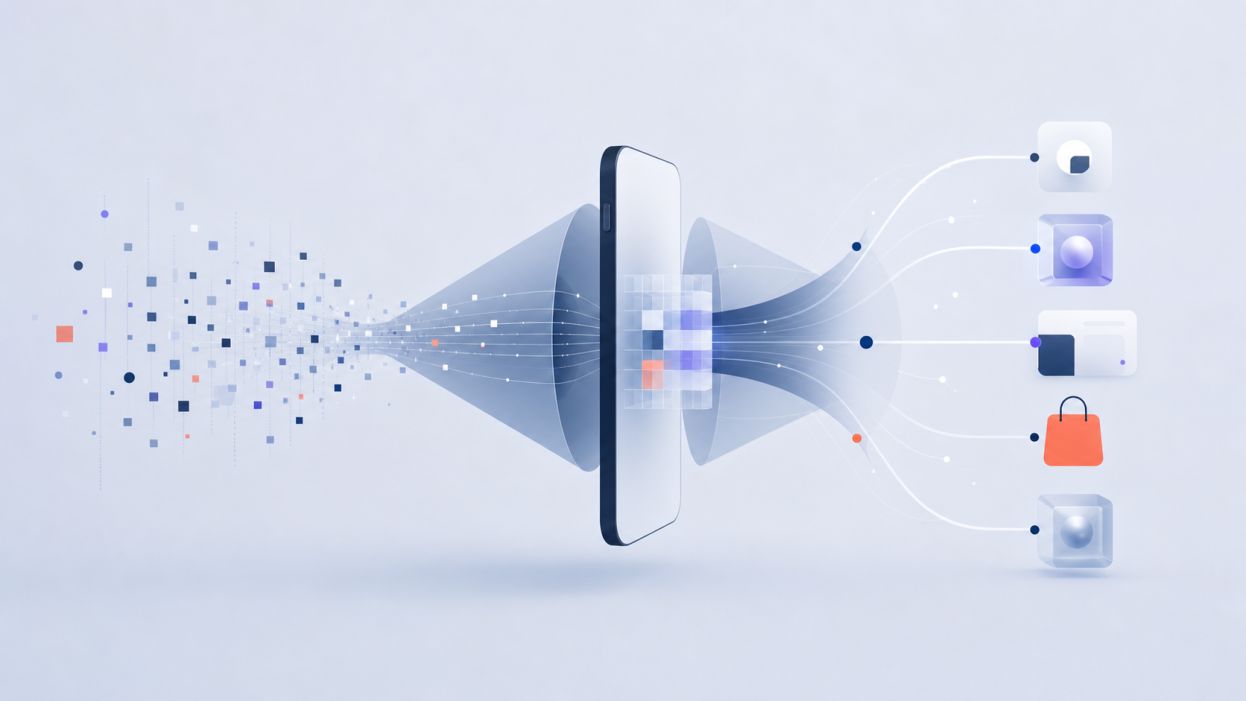
L’on-device advertising inverse partiellement la logique. Au lieu d’envoyer autant de données que possible vers des serveurs externes, le terminal conserve ou calcule localement certains signaux, puis ne transmet qu’un résultat agrégé, une cohorte, un score, une éligibilité ou un événement limité. Le ciblage peut alors s’appuyer sur des signaux disponibles localement sans nécessairement exposer l’historique utilisateur complet. Le bénéfice potentiel est double : réduire les risques de fuite de données et maintenir une capacité d’activation lorsque les identifiants cross-site ou cross-app se dégradent.
Pour les professionnels du marketing, le sujet ne doit pas être lu comme une promesse de remplacement total du ciblage data-driven. C’est un arbitrage. L’exécution locale améliore parfois la confidentialité, la latence et la pertinence contextuelle, mais elle réduit la transparence, complique l’attribution, méthode qui assigne une conversion à un ou plusieurs points de contact média, et impose de nouveaux standards de gouvernance technique. La question opérationnelle n’est donc pas : faut-il passer à l’on-device ? Elle est : quels cas d’usage justifient de déplacer le calcul sur le terminal, avec quels signaux, quelles contraintes de mesure et quelle contribution business ?
Comprendre les architectures on-device : ciblage, scoring, mesure et orchestration
Le terme on-device recouvre plusieurs architectures. La première concerne le ciblage local. Une application, un navigateur ou un système d’exploitation peut déterminer qu’un utilisateur appartient à une catégorie d’intérêt, à une cohorte ou à un segment comportemental sans transmettre l’historique détaillé. L’acheteur ne reçoit pas nécessairement les pages visitées ou les applications utilisées ; il reçoit une information d’éligibilité ou une catégorie activable.
La deuxième architecture concerne le scoring local. Le terminal peut calculer un score de propension : probabilité d’achat, probabilité de churn, probabilité d’installation, niveau d’engagement ou appétence pour une catégorie. Ce score peut être utilisé pour adapter la pression publicitaire, le message ou l’ordre de priorité entre campagnes. Dans un environnement mobile, par exemple, une application de retail peut calculer localement un score d’intention à partir de signaux récents : consultations produits, ajouts au panier, fréquence d’ouverture, catégorie consultée, localisation approximative si consentie. Le serveur n’a pas besoin de recevoir chaque micro-événement en temps réel pour décider d’une exposition.
La troisième architecture concerne la mesure. Certains frameworks limitent le reporting à des conversions agrégées, retardées ou bruitées statistiquement. Le principe est de confirmer qu’une publicité a pu contribuer à une action sans exposer un parcours individuel complet. C’est notamment l’esprit de plusieurs initiatives privacy sandbox, SKAdNetwork dans l’écosystème iOS ou Attribution Reporting dans les navigateurs : réduire l’observabilité user-level tout en conservant une mesure exploitable au niveau campagne.
La quatrième architecture concerne l’orchestration créative. Le terminal peut choisir une variante de création selon des signaux locaux : langue, format d’écran, état de connexion, niveau d’attention, historique d’interaction dans l’application, contexte de navigation ou heure de la journée. Ce fonctionnement peut réduire la dépendance à un ad server externe pour certaines décisions tactiques, serveur publicitaire utilisé pour diffuser, tracer et consolider les impressions, clics et conversions.
Ces architectures ne sont pas exclusives. Un même dispositif peut combiner une segmentation locale, une décision d’enchère côté serveur, une mesure agrégée et une personnalisation créative sur terminal. L’enjeu est de clarifier où se situe chaque décision. Qui calcule le segment ? Qui détient la règle d’éligibilité ? Qui contrôle la fréquence ? Qui reçoit le signal de conversion ? Qui audite la qualité du modèle ? Sans cette cartographie, l’on-device devient une boîte noire supplémentaire dans une chaîne déjà complexe.
Les cas d’usage les plus solides : mobile, retail media, CTV et drive-to-store
Le premier cas d’usage mature se situe dans le mobile app. Les applications disposent de signaux riches et récents : sessions, événements in-app, paniers, niveaux atteints dans un jeu, abonnements, préférences de contenu, interactions avec des notifications. Lorsque ces signaux restent sur le terminal ou dans un environnement fortement contrôlé, ils peuvent alimenter un ciblage ou une personnalisation sans exporter l’intégralité du comportement. Pour un annonceur d’app install, le CPA, coût par acquisition, montant dépensé pour générer une installation ou action attribuée, peut être optimisé non seulement sur l’installation, mais sur des signaux de qualité post-install calculés localement ou transmis de façon agrégée.
Le deuxième cas d’usage concerne le retail media. Les retailers possèdent des signaux transactionnels et comportementaux de forte valeur : achats récents, fréquence, panier moyen, affinités catégories, sensibilité promotionnelle, disponibilité magasin. Une partie de ces signaux peut être utilisée pour déterminer localement l’éligibilité d’un utilisateur à une campagne, notamment dans une application distributeur. L’intérêt est majeur : activer une intention commerciale très proche du point de vente tout en limitant la circulation de données individuelles hors de l’écosystème retail. Pour les marques, le ROAS, return on ad spend, ratio entre chiffre d’affaires attribué et dépenses publicitaires, doit toutefois être interprété avec prudence, car les environnements retail capturent souvent des consommateurs déjà proches de l’achat.
Le troisième cas d’usage est la CTV, connected TV, télévision connectée permettant de diffuser des publicités dans des environnements de streaming. Les téléviseurs et applications TV disposent de signaux de contexte, de device, de foyer présumé, de programme et parfois d’identifiants persistants. L’on-device peut contribuer à la limitation de fréquence au niveau du foyer, au choix créatif selon le contexte ou à l’exclusion de certaines catégories sensibles. Le défi reste la mesure : les conversions se produisent rarement sur le même écran. Il faut donc combiner exposition CTV, signaux agrégés, panels, clean rooms et tests d’incrémentalité, c’est-à-dire des protocoles comparant un groupe exposé à un groupe non exposé pour estimer l’effet causal de la publicité.
Le quatrième cas d’usage est le drive-to-store. Un terminal mobile peut exploiter des signaux locaux de géographie approximative, de présence dans une zone ou de proximité d’un magasin, sous réserve de consentement explicite. L’intérêt n’est pas seulement de cibler un rayon autour d’un point de vente, pratique souvent basique. Il est de combiner proximité, intention, contexte temporel et pression média. Par exemple, une enseigne peut distinguer un utilisateur proche d’un magasin mais déjà client fréquent, d’un prospect situé dans une zone de chalandise concurrente, ou d’un client dormant exposé à une offre locale. La valeur ne vient pas du signal de localisation isolé, mais de son interaction avec la donnée commerciale.
Un cas concret permet de fixer les ordres de grandeur. Une application de grande distribution disposant de 4 millions d’utilisateurs actifs mensuels peut n’avoir que 55 % à 70 % d’utilisateurs consentis pour certaines finalités publicitaires selon le pays, le contexte de recueil et la proposition de valeur. En ciblage serveur classique, la population activable peut encore diminuer après matching avec un DSP. En logique on-device, certaines règles d’éligibilité peuvent être appliquées directement dans l’application, ce qui préserve une partie de la capacité de personnalisation. Mais l’annonceur recevra souvent moins de granularité sur les logs, donc moins de confort pour l’analyse post-campagne.
Les signaux disponibles : richesse locale, transmission limitée et qualité variable
Les signaux on-device peuvent être classés en cinq familles. La première est le contexte immédiat : type de contenu, catégorie éditoriale, heure, langue, orientation de l’écran, réseau, format, environnement app ou web. Ces signaux sont peu sensibles lorsqu’ils ne décrivent pas un individu, mais ils peuvent être très utiles pour le ciblage contextuel et la brand safety, ensemble des dispositifs visant à éviter la diffusion publicitaire dans des environnements risqués pour la marque.
La deuxième famille est comportementale. Elle inclut les interactions récentes : produits consultés, contenus consommés, niveaux d’engagement, fréquence d’ouverture, durée de session, clics internes, recherches dans l’application. Ces signaux sont puissants parce qu’ils sont proches du moment de décision. Leur limite est leur sensibilité : selon les finalités, ils peuvent relever de la personnalisation publicitaire et nécessiter un consentement. En on-device, ils peuvent servir à calculer un score local sans être entièrement transmis, mais l’existence même du traitement doit rester gouvernée.
La troisième famille est transactionnelle. Elle concerne les achats, abonnements, paniers, montants, catégories, retours, coupons utilisés ou statut nouveau client. C’est la donnée la plus proche de la valeur business. Elle est aussi la plus délicate à exposer dans l’écosystème publicitaire. Une approche on-device peut permettre de déterminer qu’un utilisateur est éligible à une campagne de réachat sans transmettre son historique complet. Pour l’annonceur, le problème devient alors l’auditabilité : comment vérifier que le segment correspond réellement à la définition convenue ?
La quatrième famille est device et système. Elle inclut le type d’appareil, l’OS, la version d’application, l’état de connexion, parfois des signaux de performance ou de sécurité. Ces signaux servent autant à la diffusion qu’à la fraude. L’IVT, invalid traffic, trafic invalide généré par des bots ou des comportements non humains, peut être partiellement détecté localement via des incohérences d’environnement ou de comportement. Mais la détection anti-fraude exige souvent une vision réseau plus large ; le terminal seul ne voit pas les patterns intersites ou les fermes d’appareils.
La cinquième famille est identitaire ou pseudo-identitaire. Elle comprend les identifiants publicitaires, identifiants first-party, login, household ID, cohortes ou tokens temporaires. C’est la zone la plus contrainte. L’on-device ne supprime pas le besoin d’identité ; il le transforme. Au lieu de partager un identifiant stable partout, le système peut partager une preuve d’appartenance, un résultat de calcul ou une attribution agrégée. Cela réduit certains risques, mais rend plus difficile le frequency capping cross-channel, limitation de fréquence entre plusieurs canaux, et la déduplication des conversions.
Pour évaluer ces signaux, les équipes marketing doivent utiliser une grille en quatre critères : disponibilité, fraîcheur, prédictivité et gouvernance. Un signal disponible mais obsolète crée peu de valeur. Un signal très prédictif mais non activable légalement est inutilisable. Un signal local puissant mais non auditable crée un risque de dépendance plateforme. La maturité consiste à ne pas confondre volume de signal et qualité décisionnelle.
Contraintes techniques : latence, batterie, modèles embarqués et interopérabilité
Déplacer du calcul sur le terminal crée des contraintes opérationnelles réelles. La première est la latence. Une décision publicitaire doit souvent être prise en quelques dizaines ou centaines de millisecondes, notamment en RTB, real-time bidding, mécanisme d’enchères en temps réel permettant d’acheter une impression au moment où elle devient disponible. Si le terminal doit calculer un segment, vérifier une règle de consentement, choisir une création et renvoyer un signal à une plateforme, l’architecture doit être extrêmement optimisée. Sinon, la publicité arrive trop tard, le rendu échoue ou l’expérience utilisateur se dégrade.
La deuxième contrainte est la consommation de ressources. Les modèles embarqués, c’est-à-dire des modèles de scoring ou de machine learning exécutés localement, consomment CPU, mémoire et batterie. Une application média ou retail ne peut pas sacrifier l’expérience utilisateur pour améliorer marginalement le ciblage publicitaire. Les modèles doivent être légers, mis à jour proprement et testés sur des devices hétérogènes, du smartphone récent au terminal d’entrée de gamme. Dans certains marchés, la fragmentation Android rend cette contrainte non négligeable.
La troisième contrainte est l’actualisation des modèles. Un modèle local peut devenir obsolète si les comportements changent, si les produits évoluent, si les prix sont modifiés ou si une promotion est lancée. Il faut donc définir une cadence de mise à jour, un mécanisme de rollback et des tests A/B. Un modèle de propension entraîné sur une période promotionnelle peut surpondérer la sensibilité prix. Un score entraîné sur des clients existants peut mal prédire les prospects. L’on-device ne dispense pas des disciplines classiques de data science : validation, monitoring, biais, drift et documentation.
La quatrième contrainte est l’interopérabilité. Chaque environnement peut proposer ses propres règles : navigateur, OS mobile, SDK publicitaire, application retail, CTV, walled garden, environnement fermé contrôlant ses données et sa mesure. Pour un annonceur multi-leviers, la fragmentation rend les comparaisons difficiles. Un segment local dans une application retail, une cohorte navigateur et un groupe d’intérêt CTV ne sont pas équivalents, même s’ils portent un nom proche. L’erreur fréquente est de consolider ces signaux comme s’ils avaient la même signification statistique.
Enfin, la sécurité et l’auditabilité sont critiques. Un modèle local peut être manipulé si l’environnement est compromis. Un SDK mal sécurisé peut exposer des signaux. Une règle d’éligibilité opaque peut favoriser certains inventaires ou certaines campagnes sans justification claire. Les annonceurs doivent exiger des garanties : documentation des signaux utilisés, règles de consentement, méthode de calcul des segments, fréquence de mise à jour, tests de biais, taux de couverture, mécanismes anti-fraude et conditions d’accès aux résultats agrégés.
Mesure et attribution : accepter moins de granularité, exiger plus de rigueur
La mesure est le point le plus sensible de l’on-device advertising. En limitant la circulation des identifiants, on réduit mécaniquement la capacité à reconstruire des parcours individuels complets. Les équipes habituées aux dashboards user-level doivent accepter un changement de paradigme : la précision apparente diminue, mais la qualité causale peut progresser si l’on combine mieux les méthodes.
Le premier réflexe consiste à distinguer mesure d’optimisation et mesure de décision. Pour optimiser une campagne en cours, une plateforme peut utiliser des signaux locaux ou agrégés rapides : clics, vues, événements intermédiaires, scores d’engagement. Pour décider d’un budget trimestriel, ces signaux sont insuffisants. Il faut les relier à des ventes validées, à la marge, au statut nouveau client et à l’incrémentalité. Un CPA plateforme peut être excellent si le système cible des utilisateurs déjà intentionnistes ; le CPA incrémental peut être beaucoup moins favorable.
Le deuxième réflexe est d’utiliser des designs de test. Les holdouts, groupes volontairement non exposés, sont particulièrement utiles lorsque l’environnement permet de contrôler l’éligibilité. Les geo-tests, tests comparant des zones exposées et des zones de contrôle, sont adaptés au drive-to-store, à la CTV ou aux activations locales. Le MMM, marketing mix modeling, modèle statistique estimant la contribution des leviers marketing à partir de séries temporelles agrégées, complète ces approches pour les arbitrages de portefeuille.
Le troisième réflexe est d’anticiper les effets de seuil. Les solutions on-device transmettent parfois des rapports seulement lorsque le volume minimal est atteint, afin de préserver l’anonymat. Cela peut masquer les performances de petits segments, retarder le reporting ou empêcher certaines lectures créatives. Pour une campagne à faible volume, le manque de données ne prouve pas l’absence d’impact ; il peut simplement traduire un design sous-dimensionné. Avant lancement, il faut calculer le MDE, minimum detectable effect, taille minimale d’effet détectable avec un niveau de confiance donné.
Un exemple illustre le risque. Une marque teste une activation on-device dans une application de mobilité pour promouvoir une offre locale. Le reporting agrégé montre un lift de visites magasin de 4 %, mais avec un intervalle d’incertitude large. Le ROAS attribué semble inférieur au seuil cible. Pourtant, l’analyse par zones montre que les magasins avec stock disponible et pression média suffisante atteignent un lift de 9 %, tandis que les zones sous-exposées ou en rupture diluent l’effet. La conclusion n’est pas d’arrêter le canal, mais de redéfinir les conditions de déploiement : seuil minimal d’audience, disponibilité produit, fenêtre horaire et fréquence.
En pratique, la mesure on-device impose une hiérarchie claire des preuves. Les signaux de plateforme servent à l’optimisation tactique. Les tests de lift servent à la causalité. Les données transactionnelles servent à la valeur. Le MMM sert à la cohérence macro. Aucun de ces niveaux ne suffit seul. C’est leur combinaison qui permet de piloter avec moins de granularité individuelle mais plus de discipline décisionnelle.
Gouvernance marketing : sélectionner les partenaires sur la preuve, pas sur la promesse privacy
L’on-device advertising est souvent présenté comme une réponse privacy-friendly. Cette promesse est insuffisante. Pour un annonceur, la sélection d’un partenaire doit reposer sur des critères de preuve : quelles données sont traitées localement ? Quelles données quittent le terminal ? Sous quelle base légale ? Avec quelle durée de conservation ? Quels signaux sont utilisés pour l’optimisation ? Quels rapports sont disponibles ? Comment les performances peuvent-elles être auditées ?
Un framework utile consiste à évaluer chaque solution sur cinq dimensions. Premièrement, la couverture : part de l’audience réellement adressable ou mesurable. Deuxièmement, la qualité du signal : fraîcheur, granularité, prédictivité, robustesse. Troisièmement, le contrôle : capacité à définir les règles d’éligibilité, exclusions, fréquence et priorités. Quatrièmement, la mesure : disponibilité de tests, rapports agrégés, fenêtres, déduplication et raccordement à une source transactionnelle. Cinquièmement, l’auditabilité : documentation, logs agrégés, méthodologie, conformité et transparence commerciale.
Les contrats doivent refléter cette exigence. Ils doivent préciser les finalités de traitement, les rôles de responsable de traitement ou sous-traitant, les droits d’audit, les règles de partage de données, les seuils de reporting, les méthodes de modélisation et les conditions de suppression. La gouvernance ne doit pas être laissée aux seules équipes juridiques. Les équipes média, data, analytics et finance doivent participer, car une limitation de reporting peut avoir un impact direct sur le pilotage du CPA, du ROAS et de la marge incrémentale.
Il faut aussi éviter deux excès. Le premier est le solutionnisme technique : croire qu’un traitement local rend automatiquement un dispositif conforme, performant et acceptable. La conformité dépend des finalités, du consentement, de la transparence et des droits utilisateurs. La performance dépend de la qualité des signaux, du modèle et de l’inventaire. Le second excès est le rejet de principe : refuser l’on-device parce qu’il réduit la granularité. Dans un marché où la mesure individuelle se fragilise, les organisations qui attendent le retour d’un tracking exhaustif risquent de sous-investir dans de nouveaux modes de preuve.
Conclusion : une feuille de route pour intégrer l’on-device sans créer une nouvelle boîte noire
L’on-device advertising ne remplace ni le programmatique, ni la donnée first-party, ni la mesure incrémentale. Il redistribue les fonctions entre terminal, plateforme, serveur publicitaire, DSP, environnement éditeur et système transactionnel. Sa valeur apparaît lorsque le calcul local permet de préserver un signal utile qui aurait été perdu, de réduire une exposition inutile de données ou d’améliorer la décision créative et média sans dégrader l’expérience utilisateur.
Une feuille de route actionnable tient en sept étapes. Premièrement, cartographier les cas d’usage prioritaires : mobile app, retail media, CTV, drive-to-store, personnalisation créative ou limitation de fréquence. Deuxièmement, lister les signaux disponibles localement et les classer par disponibilité, fraîcheur, prédictivité et gouvernance. Troisièmement, définir ce qui doit rester sur le terminal, ce qui peut être agrégé et ce qui doit être transmis pour l’optimisation. Quatrièmement, documenter les contraintes techniques : latence, batterie, mise à jour des modèles, compatibilité SDK et sécurité. Cinquièmement, construire un protocole de mesure adapté : holdout, geo-test, MMM, source transactionnelle et seuils statistiques. Sixièmement, négocier l’auditabilité des partenaires, y compris les méthodes de segmentation, les taux de couverture et les limites de reporting. Septièmement, relier les résultats aux KPI business : CPA incrémental, marge, nouveaux clients, fréquence utile et contribution au funnel, parcours allant de la notoriété à la conversion puis à la fidélisation.
Le point décisif est de ne pas confondre confidentialité accrue et performance démontrée. Un dispositif on-device peut être plus respectueux des données et moins efficace, ou plus contraint en reporting mais plus robuste causalement. La maturité marketing consiste à arbitrer explicitement ces dimensions. Dans un écosystème où les signaux individuels deviennent plus rares, l’avantage concurrentiel ne viendra pas de l’accumulation de données brutes, mais de la capacité à exploiter les bons signaux au bon endroit, avec une preuve mesurable de leur contribution économique.