Décrypter les faux positifs dans les filtres brand safety
Quand la protection de marque commence à coûter de la couverture utile
Les filtres brand safety ont été conçus pour éviter qu’une publicité soit diffusée dans un environnement susceptible de nuire à la marque : contenus violents, haineux, pornographiques, illégaux, désinformation manifeste ou inventaires non conformes. Le principe est difficilement contestable. Dans un achat programmatique, où des millions d’impressions sont évaluées en quelques millisecondes via RTB, real-time bidding, mécanisme d’enchères en temps réel permettant d’acheter une impression lorsqu’elle devient disponible, l’annonceur ne peut pas auditer chaque page manuellement. Il délègue donc une partie du contrôle à des technologies de classification, d’exclusion et de vérification.
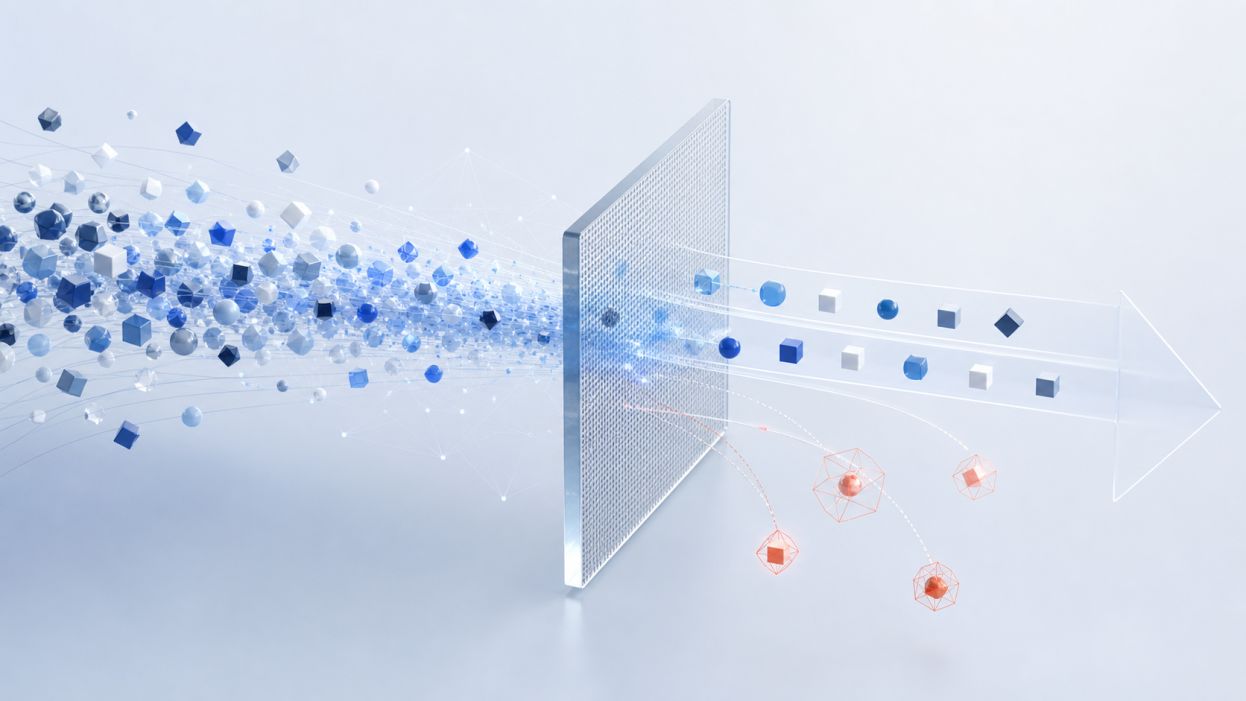
Le problème apparaît lorsque ces filtres bloquent des contenus qui ne présentent pas réellement de risque pour la marque. C’est le faux positif : une impression, une page, une vidéo ou une application est classée comme dangereuse alors qu’elle aurait pu être achetée sans dommage, parfois même avec une forte pertinence contextuelle. En brand safety, le faux positif est moins spectaculaire qu’une publicité diffusée à côté d’un contenu toxique, mais il peut être économiquement massif. Il réduit la couverture, augmente les CPM, coût pour mille impressions, déforme les algorithmes d’achat, prive les éditeurs premium de revenus et peut affaiblir la performance en bas de funnel, c’est-à-dire dans les étapes proches de la conversion.
Pour les directions marketing, l’enjeu n’est donc pas de choisir entre sécurité et performance. L’enjeu est de calibrer le niveau de risque acceptable en fonction de la marque, du pays, de la catégorie, du format, de l’objectif média et du contexte éditorial. Une stratégie trop permissive expose à des incidents de marque. Une stratégie trop restrictive détruit de la valeur en excluant des environnements légitimes. Dans certains audits programmatiques, les taux de blocage liés à la brand safety ou à la brand suitability peuvent représenter 5 % à 20 % des opportunités d’achat selon les listes de mots-clés, les catégories exclues et les paramètres du DSP, demand-side platform, plateforme utilisée par les acheteurs pour acheter des impressions publicitaires de manière automatisée. Sur des inventaires d’actualité, de sport, de santé ou de finance, les taux peuvent être encore plus élevés.
Décrypter les faux positifs suppose donc de dépasser une lecture binaire, safe ou unsafe. Il faut comprendre comment les filtres classent les contenus, pourquoi ils se trompent, où se situe le coût d’opportunité et comment mettre en place une gouvernance capable d’arbitrer entre protection, reach, qualité média et performance business.
Comprendre la différence entre brand safety et brand suitability
La première source de faux positifs vient d’une confusion fréquente entre brand safety et brand suitability. La brand safety désigne la protection minimale contre des environnements objectivement risqués ou inacceptables : contenus violents explicites, discours haineux, contenus adultes, piratage, drogues illégales, fraude, désinformation grave ou incitation à des comportements dangereux. Elle vise un socle de conformité généralement partagé par la majorité des annonceurs.
La brand suitability, ou adéquation de marque, va plus loin. Elle cherche à déterminer si un contenu est approprié pour une marque donnée, compte tenu de son positionnement, de sa catégorie, de son ton, de sa sensibilité réglementaire et de sa tolérance au risque. Une compagnie d’assurance peut vouloir éviter certains contenus sur les catastrophes naturelles pendant une campagne d’acquisition. Une marque automobile peut accepter un article sur la sécurité routière, mais refuser une vidéo montrant un accident violent. Une marque de santé peut trouver pertinent un article médical sur le diabète, alors qu’une liste de mots-clés trop large bloquerait automatiquement le terme maladie.
Les frameworks reconnus, notamment les recommandations de la GARM, Global Alliance for Responsible Media, et les taxonomies de contenu de l’IAB, Interactive Advertising Bureau, ont aidé le marché à structurer les niveaux de risque. Ils distinguent généralement des catégories de contenu et des degrés de gravité : contenu acceptable, risque faible, risque moyen, risque élevé. Cette graduation est essentielle, car toutes les occurrences d’un thème sensible ne se valent pas. Un article d’enquête sur la cybercriminalité dans un média économique n’a pas le même risque qu’un forum promouvant des activités illégales. Une vidéo d’information sur un conflit armé n’est pas équivalente à un contenu glorifiant la violence.
Le faux positif naît souvent d’un paramétrage qui transforme une logique graduée en exclusion absolue. Par exemple, une marque exclut la catégorie violence dans son outil de vérification. Le filtre bloque alors non seulement les contenus choquants, mais aussi des articles d’actualité sur la politique internationale, des analyses de sécurité, des contenus sportifs mentionnant une défaite brutale ou des critiques de films d’action. Le risque initial était réel ; la règle d’exclusion devient trop large.
Pour les professionnels du marketing, la bonne question n’est pas seulement : ce contenu contient-il un mot ou un signal sensible ? Elle est : quel est le risque réel pour cette marque, dans ce contexte, avec ce format, cette création et cet objectif ? Une impression vidéo pre-roll non skippable avant un contenu très émotionnel n’a pas le même niveau d’association qu’une bannière display en bas d’un article long. Le format, la visibilité, la durée d’exposition et la proximité sémantique doivent entrer dans l’évaluation.
Pourquoi les filtres produisent des faux positifs : mots-clés, contexte et limites du NLP
Historiquement, beaucoup de dispositifs brand safety ont reposé sur des listes de mots-clés. Le principe est simple : si une page contient un terme sensible, l’impression est bloquée. Cette méthode reste utile pour certains risques évidents, mais elle produit mécaniquement des faux positifs, car le langage est ambigu. Le mot tir peut désigner une arme, un tir au but, une photographie ou un tirage financier. Le mot crise peut renvoyer à une crise sanitaire, une crise de croissance, une crise énergétique ou une crise de réputation. Le mot cancer peut apparaître dans un article médical de haute qualité, un témoignage patient, un horoscope ou un contenu de désinformation.
Les technologies plus récentes utilisent le NLP, natural language processing, traitement automatique du langage naturel permettant d’analyser le sens d’un texte. Elles évaluent le contexte, les entités nommées, la tonalité, la syntaxe, la proximité entre mots et parfois les images, l’audio ou les métadonnées vidéo. Cette approche réduit certains faux positifs, mais elle ne les supprime pas. Les modèles peuvent manquer de finesse sur l’ironie, les citations, les contenus multilingues, les titres sensationnalistes, les commentaires utilisateurs, les vidéos sans transcription fiable ou les pages où l’article principal est noyé dans des modules recommandés.
Un exemple courant concerne l’actualité. Un média publie un article intitulé Comment les marques peuvent communiquer pendant une crise. Une liste de mots-clés peut bloquer la page à cause du terme crise. Un modèle contextuel plus avancé devrait comprendre qu’il s’agit d’un contenu marketing et management, potentiellement très pertinent pour une audience B2B. Mais si le modèle associe crise à risque élevé sans distinguer la nature de l’article, l’inventaire sera exclu. L’annonceur perd une opportunité qualifiée, l’éditeur perd une monétisation légitime, et le DSP apprend à éviter une poche d’audience pourtant cohérente.
Les faux positifs sont aussi amplifiés par les métadonnées. Une page peut être classée par un éditeur dans une rubrique actualité générale, puis requalifiée par un SSP, supply-side platform, plateforme utilisée par les éditeurs pour vendre leur inventaire, puis par un outil de vérification tiers, puis par le DSP. Chaque couche ajoute sa propre taxonomie et ses propres seuils. Une incohérence entre ces classifications peut déclencher un blocage. Dans la vidéo et le CTV, connected TV ou télévision connectée, la complexité augmente encore : le titre du programme, la description, la catégorie de l’application et le contexte de diffusion ne décrivent pas toujours précisément la séquence publicitaire.
Il faut également distinguer faux positif de précaution volontaire. Une marque très sensible peut décider d’éviter toute actualité chaude pendant une période de crise. Ce n’est pas nécessairement une erreur : c’est un choix de risque. Le faux positif devient problématique lorsque le blocage ne correspond pas à la politique décidée, ou lorsque les équipes ignorent le volume, la nature et le coût des impressions perdues.
Mesurer le coût économique des faux positifs dans l’achat programmatique
Un faux positif a un coût direct : l’impression n’est pas achetée. Mais son coût réel est plus large. Il peut réduire la couverture nette, dégrader la qualité contextuelle, déplacer les budgets vers des inventaires moins premium, augmenter les CPM effectifs et biaiser les optimisations algorithmiques. Dans un environnement RTB, chaque blocage modifie le pool d’opportunités disponible. Si les filtres excluent une part importante des médias d’actualité, le DSP peut reporter la dépense vers des sites de divertissement, des applications longues traînes ou des environnements moins alignés avec la cible.
Le coût doit être analysé en plusieurs niveaux. Le premier est le taux de blocage : part des impressions éligibles refusées par les filtres brand safety ou suitability. Le deuxième est le coût d’opportunité média : CPM moyen, visibilité, contexte, audience et format des impressions bloquées. Le troisième est le coût business : impact potentiel sur CPA, coût par acquisition, montant dépensé pour générer une conversion attribuée, ROAS, return on ad spend, ratio entre chiffre d’affaires attribué et dépenses publicitaires, visites qualifiées, leads validés ou nouveaux clients. Le quatrième est le coût éditeur : perte de revenus sur des contenus de qualité, qui peut fragiliser les environnements mêmes que les annonceurs disent vouloir financer.
Un cas chiffré illustre le sujet. Une marque B2B lance une campagne display et vidéo de 500 000 euros sur trois mois, avec un objectif de génération de leads. Les paramètres brand safety bloquent 14 % des bid requests disponibles, dont 45 % proviennent de médias économiques et technologiques premium. Le CPM moyen des impressions bloquées est de 9 euros, contre 6 euros sur les impressions achetées, mais leur taux de visibilité moyen estimé est de 72 %, contre 58 % sur le reste du plan. Après audit, 60 % des impressions bloquées concernent des articles contenant des termes comme crise, attaque, faille ou risque, dans un contexte de cybersécurité ou de transformation des entreprises. Si ces environnements avaient été réintégrés avec une règle de suitability plus fine, la campagne aurait pu gagner en couverture qualifiée, même avec un CPM plus élevé.
Le piège est de piloter uniquement le taux de blocage comme un indicateur positif. Un taux de blocage élevé peut signifier que la campagne évite beaucoup de risques. Il peut aussi signifier que la stratégie est trop restrictive. À l’inverse, un taux faible ne garantit pas la sécurité si les catégories sensibles sont mal détectées. Le KPI pertinent n’est donc pas le blocage en soi, mais le ratio entre risque évité et valeur perdue. Cette mesure est plus difficile, mais beaucoup plus utile pour arbitrer.
Les équipes avancées construisent un tableau de bord de faux positifs probables. Elles échantillonnent les URL ou contenus bloqués, les classent manuellement sur un sous-ensemble représentatif, puis extrapolent par catégorie, éditeur, format, pays et règle de blocage. Si 1 000 contenus bloqués sont audités et que 420 sont jugés acceptables au regard de la politique de marque, le taux de faux positifs sur l’échantillon est de 42 %. Ce chiffre ne doit pas être appliqué aveuglément à tout le plan, mais il donne une base pour recalibrer les seuils.
Construire une politique de risque par niveau plutôt qu’une blacklist universelle
La correction des faux positifs commence par la gouvernance, pas par l’outil. Beaucoup d’annonceurs empilent des exclusions historiques : mots-clés ajoutés après un incident, catégories bloquées par défaut, listes héritées d’une ancienne agence, paramètres globaux appliqués à tous les marchés. Le résultat est une politique de brand safety qui paraît prudente mais dont personne ne connaît vraiment la logique.
Un framework opérationnel consiste à classer les contenus en quatre niveaux. Niveau 0 : contenus interdits, à exclure systématiquement, comme haine, pornographie, piratage, incitation à la violence ou fraude manifeste. Niveau 1 : contenus à risque élevé, généralement exclus sauf exception justifiée, par exemple tragédies récentes, contenus extrêmement polarisants ou désinformation sensible. Niveau 2 : contenus à risque modéré, éligibles selon le contexte, le format, le pays, la campagne et le message créatif. Niveau 3 : contenus sensibles mais légitimes, souvent acceptables, comme actualité économique, santé éducative, cybersécurité, sport de combat réglementé, politique institutionnelle ou contenus de prévention.
Cette grille doit être reliée aux objectifs de campagne. Une campagne de notoriété grand public avec une création émotionnelle peut justifier une prudence accrue. Une campagne B2B sur la cybersécurité ne peut pas exclure tous les contenus qui parlent d’attaque, de faille ou de ransomware, sinon elle se prive précisément des contextes où l’audience est la plus attentive. Une campagne retail media pour une marque alimentaire peut éviter les contenus sur les intoxications ou rappels produits, mais accepter des articles de consommation sur l’inflation alimentaire si le ton est analytique.
La politique doit aussi distinguer les formats. En display, le risque d’association peut être plus faible si la publicité est peu intrusive ou éloignée du contenu sensible. En vidéo instream, l’association est plus forte, car l’utilisateur perçoit souvent la publicité comme intégrée à l’expérience. En social, les commentaires et la viralité peuvent modifier le risque après diffusion. En native advertising, le risque dépend de la proximité éditoriale perçue. Une règle uniforme appliquée à tous les formats crée donc soit trop de faux positifs, soit trop de risque résiduel.
Le passage d’une blacklist universelle à une matrice de risque permet d’introduire de la nuance. On peut définir des règles par catégorie : exclusion stricte des contenus illégaux, acceptation des contenus d’information sur la santé si source reconnue, acceptation des articles économiques sur la crise avec tonalité neutre ou analytique, exclusion des contenus violents visuels en vidéo, acceptation de certains sports de combat sur environnements premium. Le but n’est pas de tout autoriser, mais d’éviter que la peur d’un incident pousse l’organisation à bloquer des contextes légitimes.
Auditer les signaux : URL, sémantique, image, app, seller et placement
Pour réduire les faux positifs, il faut comprendre quel signal déclenche le blocage. Une impression peut être refusée à cause d’un mot-clé dans l’URL, du titre de l’article, de la catégorie IAB déclarée, d’un signal vidéo, d’un domaine entier, d’une application, d’un seller, d’un commentaire utilisateur ou d’un score de risque agrégé. Sans accès à ce niveau de détail, les équipes ne peuvent pas corriger intelligemment. Elles se contentent de desserrer ou resserrer des seuils globaux.
L’audit doit commencer par les logs disponibles : domaine, URL ou identifiant de contenu lorsque la confidentialité le permet, catégorie de blocage, outil ayant pris la décision, SSP, seller_id, format, device, pays, heure, CPM bidé, CPM clearing, visibilité mesurée et performance post-exposition. Le seller_id identifie le vendeur déclaré dans la supply chain programmatique. Il permet de distinguer un blocage lié au contenu d’un blocage lié à la qualité du chemin d’achat. Un même domaine peut être acceptable via un deal direct premium et plus risqué via une chaîne de revente opaque.
La supply path optimization, ou SPO, pratique consistant à rationaliser les chemins d’achat programmatique, joue ici un rôle indirect. Plus la chaîne est longue, plus les signaux de contenu peuvent être dégradés ou incohérents. Une URL tronquée, une catégorie mal transmise ou un domaine masqué augmentent le risque de blocage préventif. Dans certains environnements, l’absence de transparence conduit les outils à classer l’impression comme non sûre, non pas parce que le contenu est toxique, mais parce qu’il est insuffisamment documenté. Ce type de faux positif est en réalité un problème de qualité de signal.
Les environnements applicatifs posent une difficulté spécifique. Une application peut être globalement classée comme jeu, divertissement ou social, mais contenir des espaces publicitaires très différents. Dans le mobile in-app, le bundle ID, identifiant d’une application, doit être contrôlé, mais il ne suffit pas toujours à qualifier le contexte exact. Une exclusion trop large de catégories d’applications peut priver la campagne d’audiences utiles, tandis qu’une acceptation globale peut exposer à des contenus générés par les utilisateurs peu maîtrisés.
L’image et la vidéo ajoutent une autre couche. Les outils de computer vision peuvent détecter nudité, armes, sang, logos, scènes de violence ou texte incrusté. Mais ils peuvent confondre un couteau de cuisine dans une recette avec une arme, une scène de film avec une violence réelle, ou une image médicale avec un contenu choquant. Le contexte éditorial reste indispensable. L’analyse multimodale, qui combine texte, image, audio et métadonnées, réduit le risque mais ne remplace pas la validation humaine sur les catégories sensibles.
Un bon audit ne cherche pas seulement à trouver des erreurs. Il vise à construire des règles actionnables : retirer certains mots-clés trop génériques, passer des exclusions par mot à des exclusions par combinaison de termes, whitelister des éditeurs ou rubriques validés, créer des deals privés pour les environnements sensibles mais qualitatifs, ajuster les seuils par format, ou demander une meilleure transmission des signaux aux partenaires SSP et éditeurs.
Tester l’impact réel : holdouts, lift et scénarios de tolérance
Réduire les faux positifs ne doit pas se faire au doigt mouillé. Les équipes peuvent mettre en place des tests contrôlés pour mesurer l’impact d’un assouplissement ou d’un durcissement des filtres. L’objectif est de savoir si la réintégration d’une partie des inventaires bloqués améliore la performance sans augmenter le risque au-delà du seuil accepté.
Un premier protocole consiste à créer plusieurs scénarios de tolérance. Scénario A : politique stricte actuelle. Scénario B : politique modérée, avec réintégration de certains contenus d’actualité premium et suppression de mots-clés génériques. Scénario C : politique contextuelle, avec acceptation conditionnelle selon éditeur, format et tonalité. Chaque scénario est activé sur des budgets comparables, des audiences similaires et des périodes proches. Les KPI suivis doivent inclure taux de blocage, CPM, visibilité, couverture, fréquence, CTR, click-through rate ou taux de clic, visites qualifiées, CPA, ROAS, taux de conversion, mais aussi incidents détectés et volume de contenus sensibles acceptés.
Un deuxième protocole repose sur des holdouts, groupes volontairement exclus d’une modification afin de comparer les résultats. Par exemple, une marque peut maintenir la politique stricte sur 30 % du budget et appliquer une politique modérée sur 70 %, en contrôlant les écarts d’inventaire, de pays et d’audience. Si le scénario modéré réduit le CPM de 12 %, augmente la couverture de 18 %, améliore les visites qualifiées de 9 % et ne génère aucun incident significatif après audit, il devient difficile de justifier une politique strictement défensive. À l’inverse, si l’assouplissement augmente les impressions dans des environnements litigieux et dégrade la qualité post-clic, la règle stricte peut être maintenue.
Pour les campagnes de performance, l’attribution doit être interprétée avec prudence. L’attribution désigne la méthode qui assigne une conversion à un ou plusieurs points de contact marketing. Un inventaire réintégré peut afficher un CPA plus faible parce qu’il touche une audience plus intentionniste, mais il peut aussi capter des conversions naturelles. Il faut donc compléter le reporting par des tests d’incrémentalité, c’est-à-dire la mesure de ce qui n’aurait pas eu lieu sans exposition publicitaire. Le sujet brand safety ne doit pas être séparé de la mesure business : un contexte plus risqué mais non incrémental n’a pas d’intérêt ; un contexte légèrement sensible, premium et incrémental peut être rationnel si la marque l’accepte.
La brand lift, mesure de l’évolution d’indicateurs de marque comme la mémorisation, la considération ou l’intention d’achat, peut également éclairer les arbitrages. Certains contenus d’actualité ou d’analyse, souvent surfiltrés, génèrent une attention supérieure à des inventaires neutres mais peu impliquants. Si une campagne de considération gagne en mémorisation dans des contextes éditoriaux exigeants, il serait contre-productif de les exclure uniquement à cause de mots-clés génériques.
Organiser la gouvernance : qui décide du risque acceptable ?
La gestion des faux positifs échoue souvent parce que la responsabilité est fragmentée. L’équipe marque veut éviter tout incident. L’équipe acquisition veut maximiser le volume et le CPA. L’agence média applique les paramètres standards. Le trading desk optimise le delivery. L’outil de vérification fournit des scores. Le juridique intervient après coup. Les éditeurs contestent les blocages. Sans gouvernance explicite, la règle la plus restrictive finit souvent par s’imposer, non parce qu’elle est optimale, mais parce qu’elle protège chacun individuellement.
Une gouvernance mature définit d’abord une politique de risque validée par la marque, le média, le juridique, la data et, lorsque c’est pertinent, les équipes corporate communication. Cette politique précise les catégories interdites, les catégories conditionnelles, les exceptions, les formats plus sensibles, les marchés spécifiques et les procédures d’escalade. Elle doit être documentée, datée et révisée régulièrement, car les sensibilités évoluent. Une marque peut accepter certains sujets en période normale et les exclure temporairement lors d’une crise sectorielle.
Ensuite, il faut établir des droits de décision opérationnels. Qui peut whitelister un éditeur ? Qui peut retirer un mot-clé ? Qui valide un deal privé sur une rubrique d’actualité sensible ? Qui arbitre si le taux de blocage dépasse 25 % sur une campagne stratégique ? Qui analyse les incidents potentiels ? Ces questions doivent être réglées avant le lancement, pas au milieu d’une campagne sous pression de delivery.
La relation avec les éditeurs et les plateformes doit aussi être structurée. Les médias premium ont intérêt à fournir des signaux plus fins : taxonomie article, tonalité, type de contenu, auteur, rubrique, niveau de modération, métadonnées vidéo, conformité ads.txt et app-ads.txt. Les annonceurs ont intérêt à ne pas pénaliser mécaniquement les éditeurs d’information avec des listes de mots-clés trop larges. Un dialogue technique peut permettre de créer des packages contextuels validés, par exemple cybersécurité B2B, finance responsable, santé prévention ou actualité économique, avec des règles de suitability adaptées.
Enfin, les faux positifs doivent être intégrés aux bilans de campagne. Un reporting sérieux ne devrait pas seulement présenter les impressions servies, la visibilité, le CPA ou le ROAS. Il devrait aussi inclure les impressions bloquées par catégorie, les principaux déclencheurs de blocage, le taux de faux positifs estimé sur échantillon, le coût d’opportunité, les ajustements réalisés et les recommandations pour la vague suivante. La brand safety devient alors un paramètre d’optimisation, pas une case de conformité figée.
Conclusion : réduire les faux positifs sans affaiblir la protection de marque
Les faux positifs dans les filtres brand safety ne sont pas un détail technique. Ils révèlent la tension centrale du programmatique : automatiser la décision d’achat tout en respectant la complexité du contexte éditorial. Un filtre trop naïf bloque des contenus légitimes. Un filtre trop souple expose la marque. Un filtre performant ne se contente pas de détecter des mots ; il interprète un risque en fonction d’une politique de marque, d’un format, d’un objectif et d’un environnement.
Une feuille de route actionnable peut s’organiser en sept étapes. Premièrement, distinguer clairement brand safety et brand suitability, en séparant les risques interdits des contextes simplement sensibles. Deuxièmement, remplacer les blacklists génériques par une matrice de risque graduée, alignée avec les objectifs de campagne. Troisièmement, auditer les faux positifs sur échantillon, en identifiant les règles, mots-clés, catégories ou signaux responsables du blocage. Quatrièmement, mesurer le coût d’opportunité : couverture perdue, CPM, visibilité, qualité contextuelle et impact business potentiel. Cinquièmement, tester plusieurs niveaux de tolérance via scénarios contrôlés, holdouts ou analyses de lift. Sixièmement, améliorer la qualité des signaux avec les éditeurs, SSP, DSP et outils de vérification, notamment sur les URL, métadonnées vidéo, rubriques et taxonomies. Septièmement, installer une gouvernance de décision qui précise qui peut assouplir, durcir, whitelister ou escalader.
Le bon objectif n’est pas de réduire le taux de blocage au minimum. Il est de maximiser la valeur des impressions réellement acceptables, tout en maintenant un niveau de risque cohérent avec la marque. Dans un marché où l’attention de qualité devient rare et où les environnements éditoriaux premium sont sous pression, surbloquer par réflexe revient parfois à pénaliser les meilleurs contextes. La maturité consiste à accepter que la sécurité de marque n’est pas une variable binaire, mais un système d’arbitrage mesurable entre risque, contexte, attention et performance.