Server-side ad tracking : impacts sur la mesure et la conformité
Le tracking server-side déplace le point de contrôle de la mesure publicitaire
La bascule vers le server-side ad tracking n’est pas une simple évolution d’implémentation. Elle modifie l’architecture de collecte, la qualité des signaux utilisés pour l’optimisation média, la gouvernance du consentement et la répartition des responsabilités entre annonceur, agence, plateforme et prestataire de mesure. Dans un marché où les cookies tiers disparaissent progressivement, où les navigateurs limitent le tracking client-side et où les régulateurs exigent une traçabilité plus stricte des traitements, le sujet devient central pour les directions marketing.
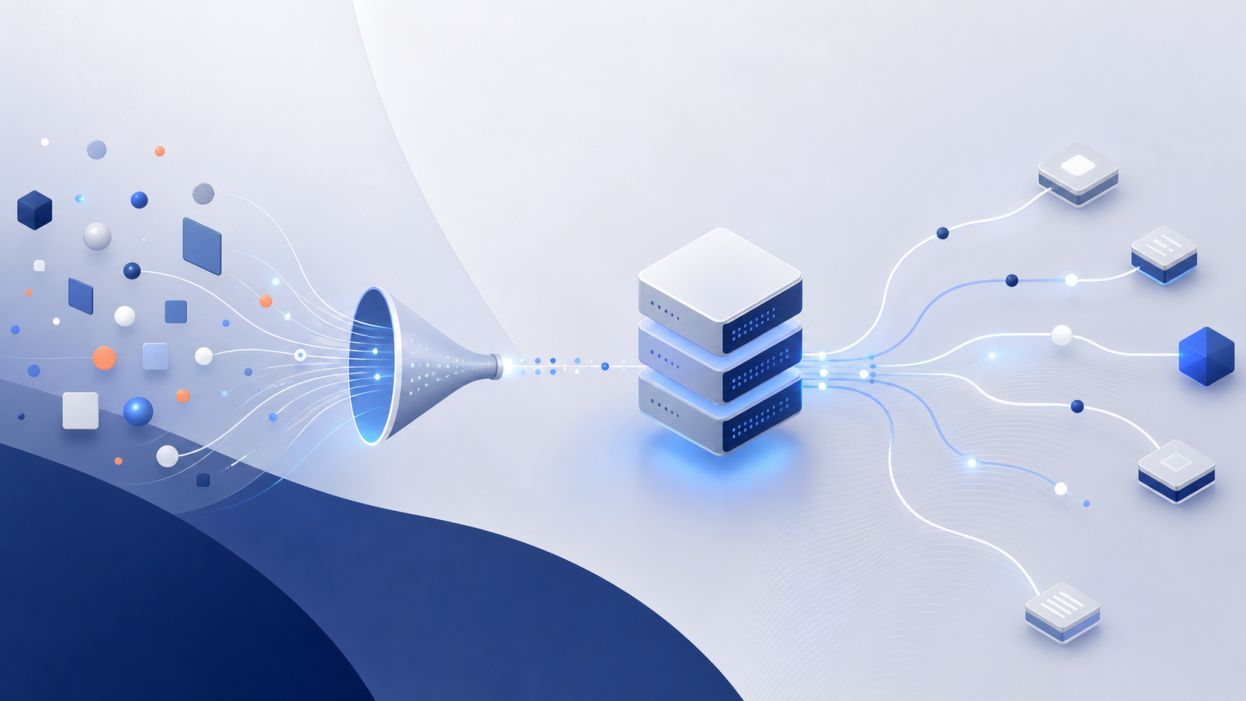
Le tracking client-side repose historiquement sur des tags exécutés dans le navigateur ou dans l’application de l’utilisateur. Un pixel de conversion, un script analytics ou un SDK, software development kit, bibliothèque intégrée dans une application mobile, transmet directement des événements à une plateforme publicitaire ou de mesure. Le tracking server-side inverse partiellement ce flux : l’événement est collecté par un serveur contrôlé par l’annonceur ou par un environnement mandaté, puis transmis aux partenaires via des API, application programming interfaces, interfaces permettant à deux systèmes d’échanger des données de façon structurée.
Cette architecture promet trois bénéfices : réduire les pertes de signal liées aux bloqueurs, mieux maîtriser les données envoyées aux partenaires et fiabiliser la mesure des conversions. Mais elle introduit aussi trois risques : recréer un tracking opaque sous couvert de performance, transmettre des données personnelles sans base légale robuste, et produire des mesures moins comparables avec les historiques client-side. Pour les professionnels du marketing, l’enjeu n’est donc pas de migrer vers le server-side parce que le marché le fait. Il est de comprendre quelles données doivent être collectées, transformées, enrichies, pseudonymisées ou exclues, et avec quel impact sur le CPA, coût par acquisition, le ROAS, return on ad spend, ratio entre chiffre d’affaires attribué et dépenses publicitaires, et l’attribution.
Le server-side tracking doit être traité comme une infrastructure de mesure et de conformité, pas comme un contournement technique. Il peut améliorer la performance apparente d’une campagne en restaurant des conversions perdues par les tags navigateur. Il peut aussi surestimer la contribution média si les règles de consentement, de déduplication et d’attribution ne sont pas strictes. La bonne question n’est pas : combien de conversions supplémentaires allons-nous récupérer ? Elle est : quelle part de signal récupéré est exploitable, conforme, dédupliquée et causalement utile pour piloter les investissements média ?
Pourquoi le client-side perd du signal : navigateurs, consentement et fragmentation des identifiants
Le tracking client-side a longtemps été efficace parce qu’il combinait exécution simple, identifiants persistants et intégration directe avec les plateformes. Un utilisateur clique sur une annonce, arrive sur un site, déclenche un tag, puis convertit. Le pixel publicitaire rapproche l’exposition, le clic et l’achat grâce à un identifiant ou à des paramètres d’URL. Ce modèle est désormais fragilisé par trois forces structurelles.
La première est la restriction technique imposée par les navigateurs et les systèmes d’exploitation. Safari et Firefox limitent depuis plusieurs années la durée de vie ou l’accès à certains identifiants. Apple a renforcé l’encadrement mobile avec ATT, App Tracking Transparency, mécanisme obligeant les applications iOS à demander une autorisation explicite pour suivre l’utilisateur entre apps et sites tiers. Chrome a engagé une réduction progressive des cookies tiers et développe des alternatives comme Privacy Sandbox. À cela s’ajoutent les ad blockers, les protections anti-fingerprinting et les restrictions sur les scripts tiers.
La deuxième force est réglementaire. Le RGPD, règlement général sur la protection des données, impose une base légale pour traiter des données personnelles, une information claire, une minimisation des données et des droits pour les personnes concernées. La directive ePrivacy, transposée dans les règles nationales sur les cookies et traceurs, exige généralement un consentement préalable pour déposer ou lire des traceurs non strictement nécessaires. Les recommandations de la CNIL en France ont renforcé l’exigence de choix libre, spécifique, éclairé et univoque. Autrement dit, un événement de conversion ne devient pas conforme parce qu’il transite par un serveur. La question de la finalité et du consentement reste centrale.
La troisième force est la fragmentation des identifiants. Les cookies tiers, les cookies first-party, données déposées dans le contexte du site visité, les identifiants logués, les ID publicitaires mobiles, les emails hashés, c’est-à-dire transformés par une fonction cryptographique, et les identifiants probabilistes ne couvrent pas les mêmes populations. Une campagne programmatique opérée via une DSP, demand-side platform, plateforme d’achat automatisé d’impressions publicitaires, ne dispose pas toujours du même signal qu’une campagne social, search ou retail media. Dans le RTB, real-time bidding, enchère en temps réel permettant d’acheter une impression lorsqu’elle devient disponible, cette perte de signal réduit la capacité à attribuer, optimiser et contrôler la fréquence.
Les pertes peuvent être significatives. Selon les environnements, les outils et les marchés, les annonceurs observent fréquemment des écarts de 10 % à 40 % entre conversions observées côté back-office et conversions remontées par les pixels publicitaires. Cet écart ne signifie pas que 40 % de la valeur média est perdue : il mélange refus de consentement, blocage technique, attribution concurrente, délais de remontée, erreurs de tagging, conversions hors ligne et différences de définition. Le server-side peut réduire une partie de cet écart, mais il ne doit pas effacer ces distinctions.
Comment fonctionne une architecture server-side robuste
Une architecture server-side mature repose sur une logique de collecte contrôlée. Lorsqu’un événement se produit sur le site ou l’application, par exemple une vue produit, un ajout panier, une demande de devis ou un achat, l’événement est d’abord envoyé vers un endpoint, point de réception technique, contrôlé par l’annonceur ou par un prestataire agissant selon ses instructions. Ce serveur reçoit les paramètres nécessaires : type d’événement, timestamp, identifiant de session, valeur de commande, devise, consentement, source de trafic, identifiants publicitaires disponibles, informations de produit et éventuellement données client pseudonymisées.
Le serveur applique ensuite des règles. Il vérifie si le consentement marketing existe pour les finalités concernées. Il supprime les champs inutiles. Il normalise les valeurs, par exemple devise, taxes, statut de commande ou identifiant produit. Il pseudonymise certains identifiants, notamment email ou téléphone hashés lorsque la base légale le permet. Il enrichit l’événement avec des données first-party, données collectées directement par l’annonceur dans sa relation avec l’utilisateur, comme le statut nouveau client, la marge, le canal de vente ou la catégorie produit. Enfin, il transmet des événements filtrés à des plateformes via API : conversion API pour les réseaux sociaux, enhanced conversions pour le search, postbacks pour l’affiliation ou endpoints propres aux DSP.
Ce modèle crée un changement important : l’annonceur devient le point de gouvernance du signal. Au lieu de laisser chaque tag tiers collecter une version complète de l’événement dans le navigateur, il décide quelles données sont envoyées, à quel partenaire, pour quelle finalité et sous quelle forme. Cette centralisation facilite la minimisation des données, mais elle augmente aussi la responsabilité opérationnelle. Une erreur de mapping peut envoyer trop de données, envoyer des données sans consentement ou dégrader la mesure en supprimant des paramètres utiles.
Un framework utile consiste à classer les événements en quatre niveaux. Premier niveau : événements strictement techniques ou analytics essentiels, par exemple fonctionnement du panier ou mesure agrégée exemptée dans certains cas. Deuxième niveau : événements marketing basiques, comme page vue, vue produit ou ajout panier, qui exigent généralement consentement lorsqu’ils alimentent des partenaires publicitaires. Troisième niveau : événements transactionnels, comme achat, revenu, marge ou statut client, particulièrement sensibles car ils révèlent un comportement économique. Quatrième niveau : événements enrichis, combinant données CRM, scoring d’audience, valeur vie client ou segmentation comportementale. Plus le niveau est élevé, plus l’exigence de justification, de minimisation et de contrôle doit être forte.
Le server-side peut être mis en œuvre avec plusieurs approches : conteneur server-side, cloud privé, reverse proxy, API propriétaire ou CDP, customer data platform, plateforme permettant d’unifier et d’activer des données clients. Chaque option a ses compromis. Un conteneur server-side est plus rapide à déployer, mais nécessite une configuration stricte. Une API propriétaire offre un contrôle maximal, mais demande davantage de ressources engineering. Une CDP simplifie l’orchestration multicanale, mais peut devenir un point de dépendance contractuelle et technique. Le choix doit être guidé par le volume, la complexité des finalités, la maturité data et le niveau de risque acceptable.
Impacts sur la mesure : plus de signal ne signifie pas automatiquement plus de vérité
Le bénéfice le plus visible du server-side tracking est la récupération de conversions. Une marque e-commerce peut constater qu’après déploiement d’une conversion API, le volume de conversions remontées à une plateforme augmente de 15 % à 25 %. Une banque ou un acteur B2B peut améliorer la remontée d’événements qualifiés, comme leads validés, rendez-vous confirmés ou dossiers signés, en évitant de dépendre uniquement du navigateur au moment de la soumission formulaire. Mais cette hausse doit être interprétée avec prudence.
Le premier enjeu est la déduplication. Une même conversion peut être envoyée par le pixel client-side et par l’API server-side. Les plateformes demandent généralement un event ID, identifiant unique d’événement, pour fusionner les deux signaux. Si cet identifiant est absent, instable ou mal propagé, la conversion peut être comptée deux fois. À l’inverse, une déduplication trop agressive peut supprimer des événements légitimes, par exemple plusieurs achats distincts dans une même session. La qualité de l’event ID, du timestamp et du transaction ID est donc critique.
Le deuxième enjeu est la fenêtre d’attribution. L’attribution désigne la méthode qui assigne une conversion à un ou plusieurs points de contact marketing. Le server-side peut transmettre des conversions plus tardives, plus qualifiées ou enrichies après validation back-office. C’est utile pour optimiser sur des événements de qualité plutôt que sur des leads bruts. Mais cela peut aussi modifier la temporalité du reporting. Un événement envoyé à J+3 n’a pas le même usage algorithmique qu’un achat remonté en temps réel. Les plateformes optimisent mieux lorsque le signal est rapide, mais les directions marketing ont besoin d’un signal fiable. L’arbitrage entre rapidité et qualité doit être explicite.
Le troisième enjeu est l’alignement avec les données de référence. Un back-office peut compter les commandes nettes, hors annulations et retours. Une plateforme publicitaire peut compter les conversions brutes attribuées dans une fenêtre post-clic ou post-view. Un outil analytics peut compter les sessions converties. Le server-side ne supprimera pas ces écarts si les définitions restent divergentes. Il peut au contraire les rendre plus visibles. Une bonne gouvernance impose un dictionnaire d’événements : définition, source de vérité, statut de consentement, règles de déduplication, valeur envoyée, fréquence d’actualisation et partenaires destinataires.
Un exemple concret illustre le risque. Un retailer observe 100 000 euros de ventes dans son back-office sur une semaine. Son pixel social en rapporte 62 000. Après déploiement server-side, la plateforme en rapporte 78 000. Le gain apparent est de 16 000 euros. Mais l’analyse montre que 6 000 euros proviennent de commandes annulées non filtrées, 4 000 euros de conversions déjà attribuées par le pixel mais mal dédupliquées, et 6 000 euros de ventes réellement récupérées. Le projet reste positif, mais l’impact réel sur la mesure est très différent du chiffre brut annoncé.
Pour le pilotage média, la métrique pertinente n’est pas seulement le taux de match, c’est-à-dire la capacité d’une plateforme à rapprocher un événement d’un utilisateur ou d’une interaction publicitaire. Il faut suivre la qualité du signal : part d’événements consentis, taux de déduplication, délai moyen de remontée, cohérence avec la source de vérité, stabilité par navigateur, taux d’événements enrichis et impact sur les décisions d’enchères. Dans une campagne optimisée au CPA, une amélioration du signal peut réduire le coût apparent par conversion. Mais si les conversions récupérées sont peu incrémentales, l’amélioration du CPA ne traduit pas forcément une meilleure rentabilité.
Conformité : le serveur n’est pas une zone grise juridique
L’une des erreurs fréquentes consiste à considérer que le server-side tracking réduit automatiquement le risque réglementaire parce que les partenaires n’exécutent plus directement leurs scripts dans le navigateur. C’est faux. Le server-side peut améliorer la conformité s’il permet de filtrer, minimiser et documenter les données. Il peut l’aggraver s’il sert à transmettre des événements sans consentement ou à masquer des traitements tiers à l’utilisateur.
Le premier principe est la finalité. Chaque transmission doit correspondre à une finalité déterminée : mesure d’audience, personnalisation publicitaire, attribution, optimisation d’enchères, création d’audiences, exclusion clients, mesure de conversion. Ces finalités ne se valent pas. Une mesure strictement agrégée et exemptée de consentement dans certaines conditions n’a pas le même régime qu’un envoi de données à une plateforme publicitaire pour optimiser une campagne. Les CMP, consent management platforms, outils permettant de recueillir et transmettre les choix de consentement, doivent donc alimenter le serveur avec des signaux exploitables par finalité et par partenaire.
Le deuxième principe est la minimisation. Envoyer un email hashé, une adresse IP, un user agent, un identifiant transactionnel et un panier détaillé à plusieurs plateformes n’est pas neutre. Même hashées, certaines données restent des données personnelles si elles peuvent être rattachées à une personne par un acteur disposant d’informations complémentaires. Le hashage n’est pas une anonymisation ; c’est le plus souvent une pseudonymisation. La différence est majeure : les données pseudonymisées restent soumises au RGPD.
Le troisième principe est la maîtrise des transferts et des sous-traitants. Les plateformes publicitaires peuvent opérer hors de l’Union européenne ou impliquer des entités globales. Les clauses contractuelles types, les analyses d’impact de transfert, les paramètres de région serveur et les engagements de traitement doivent être vérifiés. Une architecture server-side qui centralise les flux facilite l’inventaire, mais elle ne dispense pas d’une analyse juridique et contractuelle.
Le quatrième principe est la preuve. En cas de contrôle ou d’audit, il faut démontrer ce qui a été envoyé, à qui, quand, sur quelle base légale et avec quel choix utilisateur. Les logs serveur deviennent alors un actif de conformité. Mais ils deviennent aussi un risque s’ils stockent trop longtemps des données identifiantes ou s’ils ne sont pas sécurisés. Une politique de rétention doit distinguer logs techniques, logs de consentement, événements marketing et données transactionnelles.
Un modèle de gouvernance efficace repose sur une matrice simple : finalité, données collectées, base légale, statut de consentement requis, destinataire, durée de conservation, mesure de sécurité, responsable interne et preuve disponible. Cette matrice doit être maintenue par marketing, data, juridique, DPO, data protection officer, responsable de la protection des données, et équipes techniques. Le server-side tracking devient alors un dispositif contrôlé, non une boîte noire.
Effets sur l’optimisation média : algorithmes, audiences et apprentissage
Les plateformes publicitaires dépendent fortement du signal de conversion pour optimiser les enchères. Dans le programmatique, le search ou le social, un algorithme évalue la probabilité qu’un utilisateur génère une action, puis ajuste l’enchère selon la valeur attendue. Si le signal de conversion est incomplet, tardif ou bruité, l’algorithme apprend sur une représentation dégradée de la performance. Le server-side peut améliorer cette représentation, à condition d’envoyer le bon événement.
Optimiser sur un achat brut n’a pas le même effet qu’optimiser sur un achat net de retour, sur une marge ou sur un nouveau client. Pour un annonceur dont 20 % des commandes sont annulées ou retournées, envoyer des conversions brutes peut orienter les budgets vers des sources générant du volume mais peu de valeur nette. Une architecture server-side permet d’envoyer un événement de qualité, par exemple achat validé, lead scoré ou client à forte probabilité de réachat. Mais plus l’événement est qualifié, plus il arrive tard et plus son volume est faible. Il faut donc arbitrer entre signal abondant et signal utile.
Un framework opérationnel consiste à créer une hiérarchie d’événements. Au haut du funnel, parcours allant de la notoriété à la conversion, on suit les vues qualifiées, les engagements et les visites profondes. Au milieu du funnel, on suit les ajouts panier, configurations, demandes de devis ou inscriptions. En bas du funnel, on suit achats, leads validés, ventes nettes ou marge. Pour l’optimisation algorithmique, il peut être pertinent d’envoyer plusieurs événements avec des valeurs différentes plutôt qu’un seul événement final trop rare. Par exemple, un lead formulaire vaut 1, un lead validé vaut 5, une vente signée vaut 20. Cette pondération évite de laisser l’algorithme optimiser sur des signaux faibles ou trop tardifs.
Le server-side modifie aussi la création d’audiences. Les audiences d’exclusion, comme clients récents ou prospects déjà convertis, deviennent plus fiables si elles sont alimentées par le serveur. Les audiences de retargeting, c’est-à-dire reciblage des visiteurs ou prospects ayant manifesté un intérêt, peuvent être enrichies par la valeur de panier ou la catégorie consultée. Mais cette précision augmente le risque de surexposition et de captation d’attribution. Un retargeting très bien alimenté peut afficher un ROAS élevé tout en étant peu incrémental, parce qu’il touche des utilisateurs déjà proches de l’achat.
Dans les environnements DSP et retail media, le server-side peut aussi soutenir la mesure offline. Une enseigne peut réconcilier exposition publicitaire, visite magasin et achat en caisse si elle dispose d’identifiants first-party et d’un consentement approprié. Des acteurs spécialisés du marché français, dont R-Advertising dans des logiques drive-to-store et programmatique, s’inscrivent dans ces problématiques d’activation et de mesure multi-environnements. Mais la valeur du dispositif dépend toujours de la qualité du matching, de la couverture du panel client et de la rigueur des tests d’incrémentalité.
Les limites : dépendance aux plateformes, comparabilité historique et risque de surmesure
Le server-side tracking n’est pas une solution magique à la perte de signal. Sa première limite est la dépendance aux plateformes. Les conversion APIs sont conçues pour améliorer les signaux transmis à chaque écosystème. Elles renforcent parfois la capacité d’optimisation, mais elles peuvent aussi augmenter l’asymétrie d’information : chaque plateforme mesure mieux sa propre contribution selon ses règles, sans nécessairement produire une vue cross-canal objective. Une hausse des conversions rapportées par plusieurs plateformes peut aboutir à une somme attribuée supérieure au total réel.
La deuxième limite est la comparabilité historique. Après migration, les séries de CPA, ROAS, taux de conversion et attribution changent. Une campagne peut sembler progresser simplement parce que la collecte est meilleure. Il faut donc prévoir une période de double mesure, client-side et server-side, avec déduplication contrôlée. Cette période permet d’estimer l’écart par navigateur, canal, device, catégorie produit et statut de consentement. Sans ce pont méthodologique, les équipes risquent de conclure à une amélioration média qui est en réalité une amélioration de tracking.
La troisième limite est le risque de surmesure. Parce que le server-side donne plus de contrôle technique, il peut inciter à tout envoyer : panier détaillé, score CRM, statut client, marge, localisation, événements micro-conversion. Or la conformité et la qualité analytique reposent souvent sur la parcimonie. Trop de signaux peuvent dégrader les modèles, créer des incohérences entre plateformes et augmenter l’exposition réglementaire. La question à poser avant chaque champ est simple : cette donnée change-t-elle une décision d’achat média ou de mesure ? Si la réponse est non, elle ne devrait probablement pas être transmise.
La quatrième limite concerne l’incrémentalité. Le server-side améliore la mesure des conversions observées, pas la preuve causale. L’incrémentalité mesure ce qui n’aurait pas eu lieu sans exposition publicitaire. Une meilleure remontée de conversions peut améliorer le reporting, mais elle ne prouve pas que les campagnes créent plus de ventes. Les holdouts, groupes volontairement non exposés ou moins exposés, les geo-tests, tests comparant zones exposées et zones de contrôle, et les modèles de marketing mix restent nécessaires pour distinguer contribution réelle et simple attribution.
Enfin, le server-side peut créer une dette technique. Les mappings d’événements, les règles de consentement, les API partenaires et les schémas de données changent. Une implémentation non documentée devient difficile à maintenir. Les erreurs sont parfois invisibles : un champ valeur envoyé en TTC au lieu de HT, une devise mal convertie, un statut de commande non filtré, un consentement mal interprété. À grande échelle, ces détails peuvent déplacer des centaines de milliers d’euros de budget vers de mauvaises sources.
Conclusion : une feuille de route pour mesurer mieux sans contourner les règles
Le server-side ad tracking est une évolution structurante de la mesure publicitaire. Bien conçu, il restaure une partie du signal perdu, améliore la qualité des événements transmis aux plateformes, permet d’optimiser sur des conversions plus proches de la valeur business et renforce la maîtrise des données. Mal conçu, il devient un accélérateur d’opacité : plus de conversions rapportées, mais moins de clarté sur le consentement, la déduplication, la causalité et la responsabilité.
Une feuille de route actionnable peut s’organiser en huit décisions. Premièrement, cartographier les événements et distinguer analytics, marketing, transactionnel et enrichi. Deuxièmement, relier chaque événement à une finalité, une base légale, un statut de consentement et un partenaire destinataire. Troisièmement, définir un dictionnaire de données commun entre marketing, data, juridique et technique : nom d’événement, valeur, devise, timestamp, transaction ID, event ID, source de vérité et règles de déduplication. Quatrièmement, mettre en place une période de double mesure pour comparer client-side, server-side et back-office.
Cinquièmement, privilégier la minimisation : n’envoyer que les champs utiles à l’optimisation ou à la mesure, avec pseudonymisation lorsque nécessaire et sans confondre hashage et anonymisation. Sixièmement, suivre des KPI de qualité de signal : taux d’événements consentis, taux de match, délai de remontée, taux de déduplication, écart avec la source de vérité, stabilité par canal et impact sur CPA ou ROAS. Septièmement, compléter la mesure attribuée par des tests d’incrémentalité afin d’éviter que le signal récupéré ne serve surtout à mieux attribuer des ventes déjà probables. Huitièmement, documenter et auditer régulièrement les flux, les logs, les accès et les contrats partenaires.
Pour les annonceurs avancés, le succès ne se mesure pas au pourcentage de conversions récupérées. Il se mesure à la capacité de produire un signal fiable, conforme, dédupliqué, utile aux algorithmes et cohérent avec les ventes réelles. Le server-side tracking ne doit pas être un contournement des limites imposées au client-side ; il doit être une réponse plus mature à un environnement où la donnée publicitaire doit être mieux gouvernée. Dans cette perspective, il devient moins un projet de tagging qu’un projet de pilotage : mesurer moins de bruit, transmettre moins de données inutiles et décider avec davantage de preuve.